De vraag
De studieopdrachten in deep learning onderzochten hoe beeldclassificatiemodellen afhangen van de beelden en labels waarmee ze worden getraind.
De aanpak
De opdrachten gebruikten Python en Jupyter Notebooks voor het verkennen van convolutionele neurale netwerken en SimCLR. De kleinere projecten hieronder gaan over twee verschillende classificatietaken. De praktische vraag is steeds: wat moet het model precies uit deze voorbeelden leren?
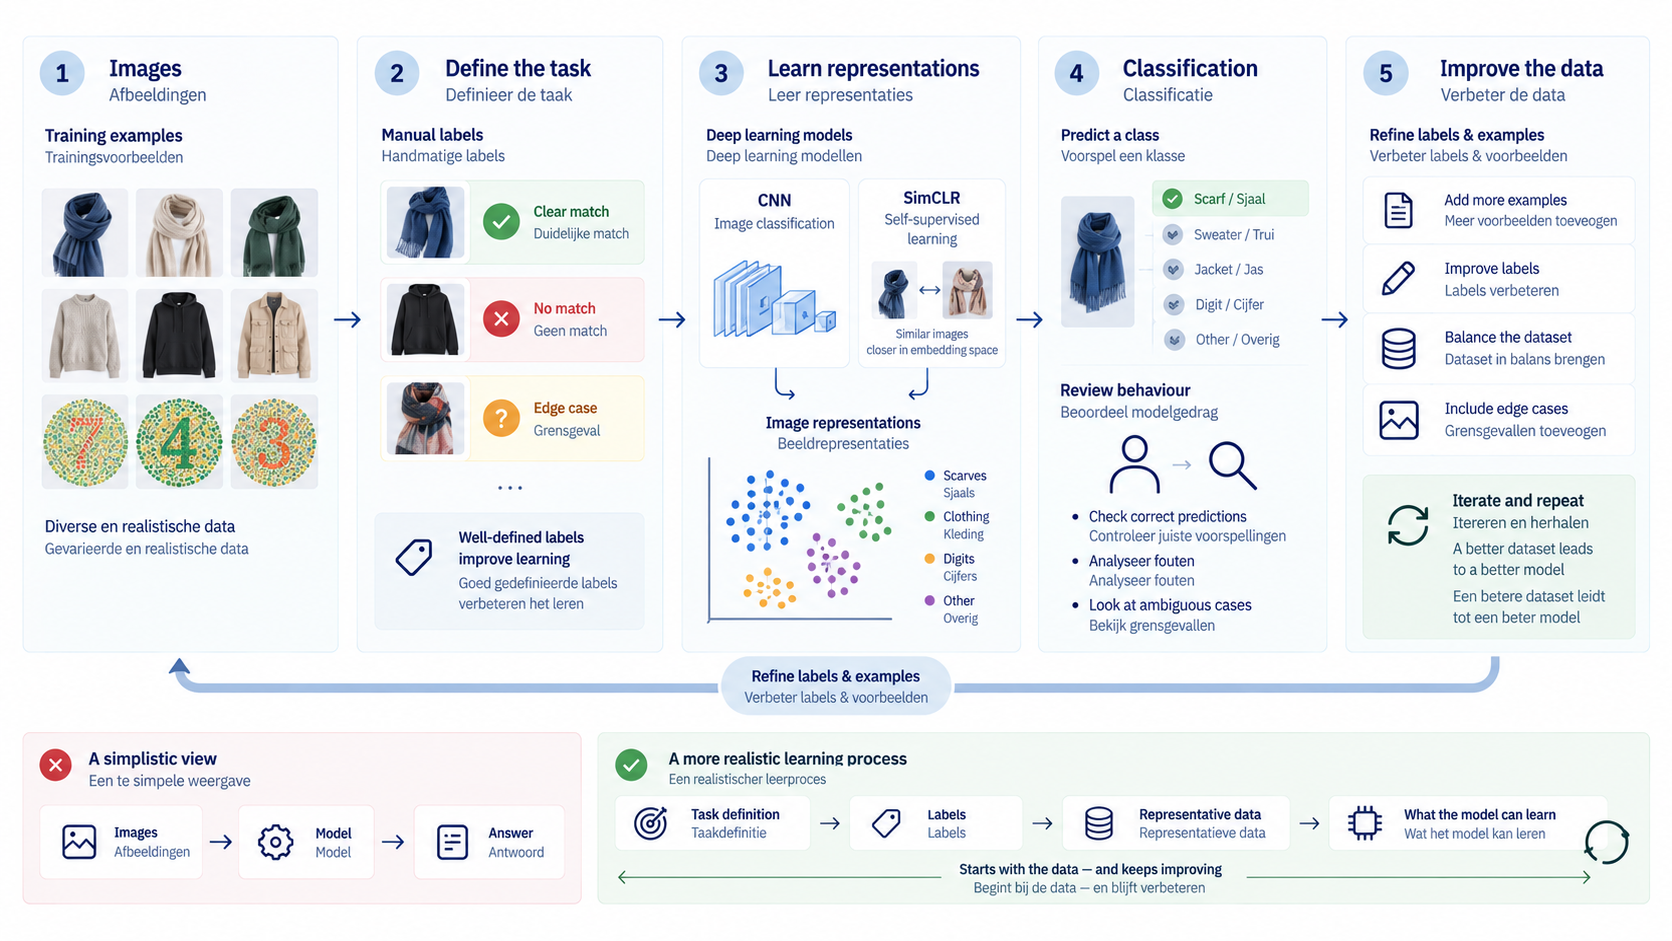
Tekstuitleg bij de infographic
Representatieve beelden en consistente labels bepalen de leeropdracht. Duidelijke matches, niet-matches en grensgevallen vragen om verschillende behandeling. CNNs en SimCLR zijn technieken die tijdens de studie zijn verkend, geen verplichte gezamenlijke productiepipeline. Classificatie en menselijke beoordeling helpen fouten en dubbelzinnige gevallen te herkennen. Die leiden terug naar betere voorbeelden, labeldefinities en balans in de dataset. Representaties en voorspelde klassen zijn conceptuele illustraties, geen gemeten modelresultaten of benchmarkscores.
De uitdaging
Een architectuur lost een onduidelijke taakomschrijving niet op. Dubbelzinnige labels en niet-representatieve trainingsvoorbeelden beïnvloeden wat een model zinvol kan leren.
Wat het opleverde
Praktijkervaring met computer vision en meer inzicht in hoe datakwaliteit en labeldefinities een ML-project bepalen. Hier worden geen benchmarkscores geclaimd.
Inzichten
Definieer de taak en bekijk grensgevallen voordat je een trainingsscore ziet als bewijs dat het model het bedoelde probleem oplost.